Trong bài viết này mình sẽ cùng các bạn tìm hiểu chi tiết về amazon simple storage service amazon s3 – một trong những dịch vụ cơ bản của AWS. Mình sẽ cố gắng giải thích một cách dễ hiểu nhất, kể cả bạn chưa biết gì về cloud vẫn có thể nắm được nha.
1. Amazon S3 là gì?
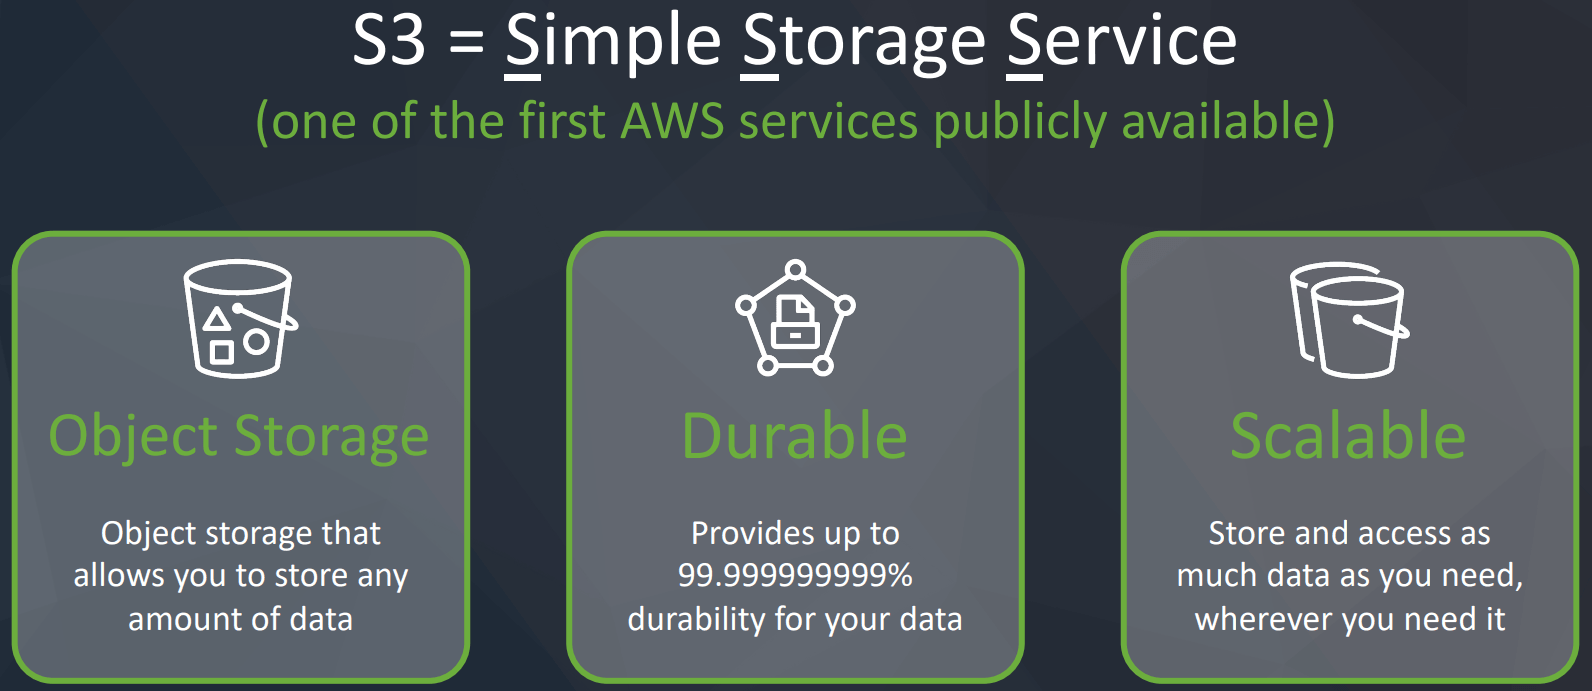
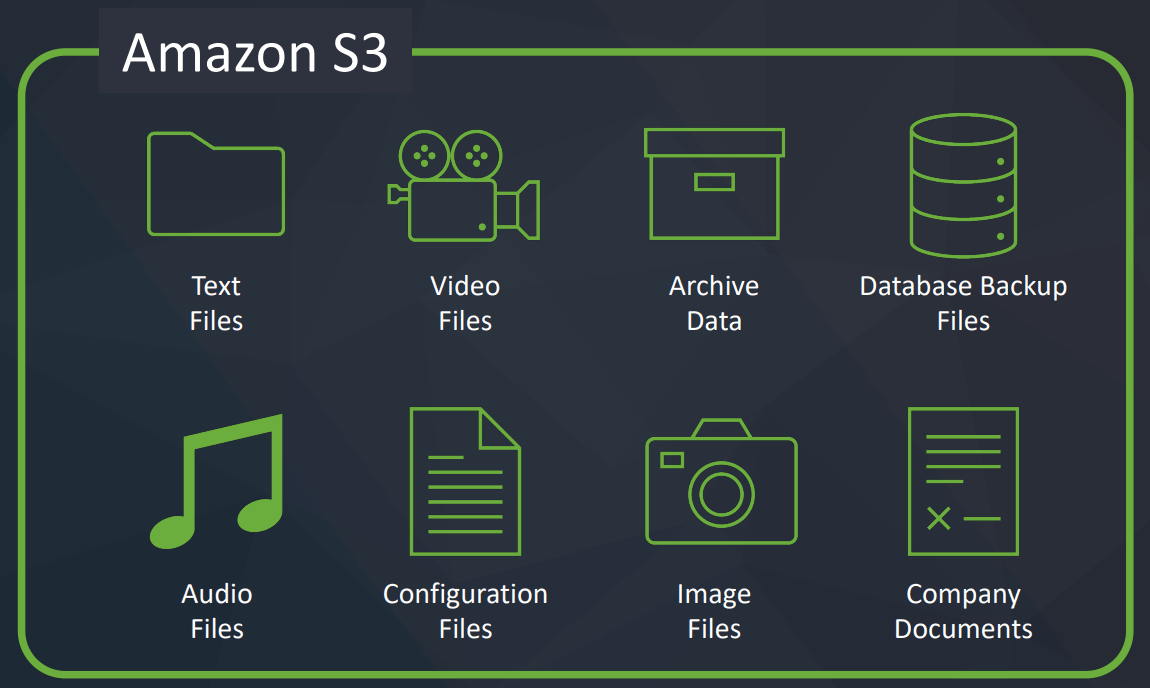
Amazon S3 (Simple Storage Service) là dịch vụ lưu trữ dạng “object” của AWS, nghĩa là bạn có thể upload đủ loại file lên – từ hình ảnh, video, tài liệu, file backup, đến dữ liệu cho data lake, machine learning,… Dịch vụ này được thiết kế để lưu trữ với độ bền rất cao (99.999999999% – nghe hơi nhiều số 9) và khả năng mở rộng thì gần như vô hạn.
2. Tại sao nên dùng Amazon S3
Thay vì phải gắn USB hay mua ổ cứng, bạn có thể “quăng” dữ liệu lên cloud, đảm bảo an toàn, truy cập dễ dàng từ mọi nơi, lại không lo mất mát. Một số ứng dụng thực tế của S3:
- Sao lưu & khôi phục dữ liệu: Gặp sự cố thì lấy lại cực nhanh.
- Lưu trữ dài hạn: Dịch vụ S3 Glacier cung cấp lưu trữ chi phí thấp, phù hợp với nhu cầu lưu trữ ít truy cập. Kiểu như archive mấy file cũ ít dùng nhưng vẫn cần giữ lại.
- Phân phối nội dung: Lưu trữ ảnh, video để truyền nhanh đến người dùng toàn cầu.
- Phân tích dữ liệu lớn: Làm data lake lưu trữ hàng trăm terabyte.
- Hosting website tĩnh: HTML, CSS, JS gì cũng chơi được luôn, không cần server.
Khi nào không nên dùng Amazon S3?
S3 là dịch vụ lưu trữ, không phải nơi để chạy ứng dụng. Dùng sai mục đích là lỗi mình thấy khá phổ biến khi mới học AWS.
Những trường hợp không nên dùng S3:
- Chạy ứng dụng hoặc thực thi code: S3 không chạy app. Dù nó host được website tĩnh, bạn vẫn dùng EC2, ECS hay Lambda để chạy logic.
- Chạy hệ điều hành hoặc cài phần mềm: dùng EC2/EBS cho việc này.
- Cần block-level storage: ứng dụng cần đọc ghi từng block như trên ổ cứng thì dùng EBS.
- Tính toán hiệu năng cao, cần độ trễ thật thấp: cân nhắc EBS hoặc EFS thay vì S3.
- Dữ liệu giao dịch (transactional) và quan hệ: dùng RDS hoặc DynamoDB làm backend cho database.
Nguyên tắc chọn nơi lưu dữ liệu: S3, EBS hay EFS?
Muốn chọn đúng nơi lưu dữ liệu trên AWS, bạn hỏi 3 câu theo thứ tự: ai truy cập dữ liệu (một máy hay nhiều máy, hay qua API), truy cập kiểu gì (đọc ghi từng block, mount như thư mục, hay lấy nguyên file) và cần độ trễ bao nhiêu. Trả lời xong 3 câu này là gần như chọn được dịch vụ.
Cách nhớ nhanh:
- S3: lưu file để cất, chia sẻ, phân phối. Truy cập qua API/URL.
- EBS: ổ đĩa riêng của một máy EC2.
- EFS: thư mục dùng chung cho nhiều máy Linux.
3. Cấu trúc cơ bản của S3: Buckets và Objects
3.1. Buckets
Bạn cứ hình dung bucket giống như thư mục gốc để chứa dữ liệu. Mỗi file bạn upload đều nằm trong một bucket.
- Tên bucket phải là duy nhất toàn cầu.
- Không được có ký tự in hoa, gạch dưới (_), hoặc giống địa chỉ IP.
3.2. Objects
- Objects là các tệp được lưu trữ trong buckets và được xác định bằng một key.
- Key là đường dẫn đầy đủ đến tệp, bao gồm cả các thư mục ảo. Ví dụ:
- Key:
my-folder/another-folder/my-file.txt - Trong đó,
my-folder/another-folder/là prefix, cònmy-file.txtlà tên tệp.
- Key:
- Key là đường dẫn đầy đủ đến tệp, bao gồm cả các thư mục ảo. Ví dụ:
- Metadata và Tags:
- Metadata là cặp key-value do hệ thống hoặc người dùng tạo để cung cấp thông tin bổ sung về tệp.
- Tags (tối đa 10 cặp key-value) rất hữu ích cho bảo mật và quản lý vòng đời dữ liệu.
- Kích thước tối đa:
- Một tệp có thể lớn tối đa 5 terabytes. Nếu tệp lớn hơn 5 gigabytes, bạn cần sử dụng tính năng multi-part upload để tải lên theo từng phần nhỏ hơn.
3.3. Object storage là gì? Khác gì file storage và block storage?
Object storage quản lý dữ liệu dưới dạng các object. Bạn truy cập object bằng định danh duy nhất của nó, thay vì đi qua cây thư mục như trên máy tính.
Cách hình dung dễ nhất: nó giống Google Drive hay Dropbox hơn là ổ C: trên laptop. Bạn không cần biết dữ liệu nằm ở sector nào, chỉ cần biết tên (key) của file.
Mỗi object trong S3 gồm các phần sau:
- Key: tên định danh duy nhất của object trong bucket, ví dụ
images/avatar.png - Data: nội dung thật của file
- Metadata: thông tin mô tả như kích thước, thời điểm tạo, kiểu nội dung (content type)
Mỗi object là một đơn vị độc lập, không phụ thuộc vào object khác. Nhờ vậy S3 mở rộng rất tốt, vì không bị ràng buộc bởi cấu trúc phân cấp của một hệ thống file truyền thống.
Bảng so sánh ba kiểu lưu trữ để bạn dễ phân biệt:
| Tiêu chí | Object storage (S3) | File storage (EFS) | Block storage (EBS) |
| Đơn vị dữ liệu | Object (data + metadata + key) | File trong cây thư mục | Block trên ổ đĩa |
| Cách truy cập | Qua key, API HTTP(S) | Mount như một thư mục (NFS) | Gắn vào một EC2 như ổ đĩa |
| Phù hợp nhất | Backup, media, log, data lake, static content | File dùng chung nhiều server | Ổ đĩa hệ điều hành, database cần độ trễ thấp |
| Cần chạy OS/app trên đó | Không | Có thể | Có |
4. Các lớp lưu trữ (Storage Classes)
Amazon S3 Storage Classes là gì? Phân biệt 7 lớp lưu trữ và cách chọn đúng
S3 không chỉ là “lưu là xong”. AWS chia thành nhiều loại lưu trữ để bạn tối ưu chi phí:
| Class | Availability | AZs | Min Duration | Retrieval | Use Case | Cost |
|---|---|---|---|---|---|---|
| Standard | 99.99% | ≥3 | None | Instant | Frequently accessed | $$$$ |
| Intelligent-Tiering | 99.9% | ≥3 | None | Instant | Unknown/changing patterns | $$$ |
| Standard-IA | 99.9% | ≥3 | 30 days | Instant | Infrequent access | $$ |
| One Zone-IA | 99.5% | 1 | 30 days | Instant | Non-critical, infrequent | $ |
| Glacier Instant Retrieval | 99.9% | ≥3 | 90 days | Instant | Archive, quarterly access | $ |
| Glacier Flexible Retrieval | 99.99% | ≥3 | 90 days | Min-hours | Archive, annual access | $ |
| Glacier Deep Archive | 99.99% | ≥3 | 180 days | 12 hours | Long-term archive | Cheapest |
4.1. Amazon S3 Standard
- Tính năng:
- Truy cập dữ liệu thường xuyên.
- Độ trễ thấp, thông lượng cao.
- Tính sẵn sàng: 99.99%.
- Ứng dụng:
- Phân tích dữ liệu lớn.
- Ứng dụng di động và game.
- Phân phối nội dung.
4.2. Amazon S3 Standard-Infrequent Access (IA)
- Tính năng:
- Dữ liệu ít được truy cập nhưng cần truy xuất nhanh khi cần.
- Chi phí lưu trữ thấp hơn S3 Standard.
- Có chi phí truy xuất dữ liệu.
- Tính sẵn sàng: 99.9%.
- Ứng dụng:
- Sao lưu dữ liệu.
- Phục hồi sau thảm họa (Disaster Recovery).
4.3. Amazon S3 One Zone-Infrequent Access (One Zone-IA)
- Tính năng:
- Lưu trữ trong một vùng sẵn sàng (AZ) duy nhất.
- Chi phí thấp hơn Standard-IA.
- Nguy cơ mất dữ liệu nếu AZ bị lỗi.
- Tính sẵn sàng: 99.5%.
- Ứng dụng:
- Lưu trữ bản sao dữ liệu thứ cấp.
- Dữ liệu có thể tái tạo dễ dàng.
4.4. Glacier Instant Retrieval
- Tính năng:
- Truy xuất trong mili-giây.
- Dành cho dữ liệu truy cập theo quý.
- Thời gian lưu trữ tối thiểu: 90 ngày.
- Ứng dụng: Sao lưu dữ liệu cần truy xuất nhanh.
4.5. Glacier Flexible Retrieval
- Tính năng:
- Cung cấp các tùy chọn truy xuất:
- Expedited: 1–5 phút.
- Standard: 3–5 giờ.
- Bulk: 5–12 giờ (miễn phí).
- Thời gian lưu trữ tối thiểu: 90 ngày.
- Cung cấp các tùy chọn truy xuất:
- Ứng dụng: Lưu trữ dữ liệu không yêu cầu truy xuất nhanh.
4.6. Glacier Deep Archive
- Tính năng:
- Chi phí thấp nhất.
- Tùy chọn truy xuất:
- Standard: 12 giờ.
- Bulk: 48 giờ.
- Thời gian lưu trữ tối thiểu: 180 ngày.
- Ứng dụng: Lưu trữ dữ liệu dài hạn không thường xuyên truy cập.
4.7. Amazon S3 Intelligent-Tiering
- Tính năng:
- Tự động chuyển đổi giữa các lớp lưu trữ dựa trên tần suất truy cập.
- Không mất phí truy xuất dữ liệu.
- Các tầng lưu trữ:
- Frequent Access Tier: Mặc định cho dữ liệu được truy cập thường xuyên.
- Infrequent Access Tier: Dữ liệu không truy cập trong 30 ngày.
- Archive Instant Access Tier: Dữ liệu không truy cập trong 90 ngày.
- Deep Archive Access Tier: Dữ liệu không truy cập từ 180–700+ ngày.
- Ứng dụng: Tiết kiệm chi phí và giảm thiểu quản lý dữ liệu thủ công.
5. Amazon S3 Security
5.1. User-Based Security
Bảo mật người dùng trong Amazon S3 được thực hiện thông qua IAM Policies.
5.2. Resource-Based Security
Ngoài bảo mật dựa trên người dùng, Amazon S3 cung cấp cơ chế bảo mật dựa trên tài nguyên, bao gồm:
- S3 Bucket Policies: Là các quy tắc áp dụng cho toàn bộ bucket, có thể cấu hình trực tiếp từ giao diện quản lý của S3.
- Cho phép truy cập từ tài khoản khác (Cross-Account Access).
- Thiết lập các bucket công khai (public).
- Access Control List (ACL):
- Object ACL: Điều chỉnh quyền chi tiết cho từng đối tượng.
- Bucket ACL: Ít phổ biến và thường bị vô hiệu hóa.
Bucket Policy trong S3 được viết dưới dạng JSON, bao gồm:
- Resource: Xác định bucket hoặc đối tượng mà chính sách áp dụng.
- Effect: Quy định Allow hoặc Deny hành động cụ thể.
- Action: Chỉ định các API được phép hoặc từ chối (ví dụ:
GetObject). - Principal: Xác định ai được phép thực hiện hành động (ví dụ:
*cho phép tất cả).
6. Amazon S3 Encryption
6.1. Mã Hóa Phía Máy Chủ (Server-Side Encryption – SSE)
Mã hóa phía máy chủ được quản lý bởi Amazon S3 và có ba loại chính:
SSE-S3
- Mô tả: Sử dụng khóa mã hóa được quản lý bởi Amazon S3. Loại mã hóa này được bật mặc định cho tất cả các đối tượng và bucket mới.
- Cách hoạt động:
- Người dùng tải tệp lên với tiêu đề
x-amz-server-side-encryption: "AES256". - Amazon S3 sử dụng khóa AES-256 do chính AWS quản lý để mã hóa đối tượng.
- Người dùng tải tệp lên với tiêu đề
- Ưu điểm: Không cần quản lý khóa, dễ dàng triển khai.
SSE-KMS
- Mô tả: Sử dụng khóa được quản lý thông qua AWS Key Management Service (KMS).
- Cách hoạt động:
- Người dùng tải tệp lên với tiêu đề
x-amz-server-side-encryption: "aws:kms". - Amazon S3 sử dụng khóa từ KMS để mã hóa đối tượng.
- Cần có quyền truy cập vào khóa KMS để đọc dữ liệu đã mã hóa.
- Người dùng tải tệp lên với tiêu đề
- Ưu điểm:
- Quản lý khóa linh hoạt hơn.
- Có thể theo dõi việc sử dụng khóa qua AWS CloudTrail.
- Nhược điểm: Giới hạn API của KMS có thể ảnh hưởng đến hiệu suất trong các trường hợp tải dữ liệu lớn.
SSE-C
- Mô tả: Sử dụng khóa mã hóa do khách hàng tự quản lý và cung cấp.
- Cách hoạt động:
- Người dùng truyền khóa mã hóa thông qua tiêu đề HTTP trong quá trình tải tệp lên.
- Amazon S3 mã hóa đối tượng nhưng không lưu trữ khóa.
- Ưu điểm: Khách hàng hoàn toàn kiểm soát khóa.
- Nhược điểm: Phải sử dụng HTTPS để đảm bảo an toàn khi truyền khóa.
6.2. Mã Hóa Phía Khách Hàng (Client-Side Encryption)
- Mô tả: Dữ liệu được mã hóa trước khi tải lên S3. Mã hóa và quản lý khóa hoàn toàn do phía khách hàng thực hiện.
- Cách hoạt động:
- Khách hàng mã hóa dữ liệu bằng khóa riêng trước khi tải lên.
- Dữ liệu được lưu trữ ở dạng mã hóa trên S3.
- Khi cần truy cập, dữ liệu sẽ được tải xuống và giải mã ở phía khách hàng.
- Ưu điểm: Hoàn toàn kiểm soát vòng đời của khóa.
- Nhược điểm: Yêu cầu thêm công cụ hoặc thư viện mã hóa như AWS SDK.
6.3. Mã Hóa Khi Truyền Dữ Liệu (Encryption in Transit)
- Khái niệm: Mã hóa dữ liệu trong quá trình truyền giữa máy khách và Amazon S3.
- Phương thức:
- HTTPS: Cung cấp kết nối an toàn, mã hóa dữ liệu khi truyền.
- Bucket Policy: Có thể ép buộc sử dụng HTTPS bằng cách thêm chính sách bucket với điều kiện
aws:SecureTransport: "false"để từ chối các yêu cầu không được mã hóa.
7. Versioning Amazon S3
Bật tính năng này thì mỗi khi bạn sửa file, S3 sẽ giữ lại cả phiên bản cũ và mới. Rất hữu ích nếu bạn lỡ xoá nhầm, hoặc cần khôi phục bản trước đó.
Ví dụ:
- Bạn upload file
index.htmllần đầu → một phiên bản đầu tiên được tạo. - Bạn chỉnh sửa và upload lại file
index.html→ một phiên bản mới được lưu, trong khi phiên bản cũ vẫn còn.
Lưu ý:
- Các đối tượng đã tồn tại trước khi bật versioning sẽ có
Version ID = null. - Tạm dừng versioning (Suspend) không xóa các phiên bản đã có. Tuy nhiên, nếu versioning bị tạm dừng, các upload mới sẽ ghi đè lên object cũ mà không tạo phiên bản mới.
- Tính năng versioning có thể làm tăng chi phí lưu trữ vì tất cả các phiên bản đều được giữ lại. Nên cân nhắc sử dụng lifecycle policy để dọn dẹp định kỳ.
8. Quy tắc lifecycle
Quy tắc lifecycle giúp tự động hóa quy trình quản lý dữ liệu trên S3. Các quy tắc này bao gồm:
8.1. Transition Action
Chuyển đổi đối tượng sang lớp lưu trữ khác sau một khoảng thời gian.
Ví dụ:
- Chuyển đối tượng sang Standard-IA sau 60 ngày.
- Chuyển đối tượng sang Glacier sau 6 tháng.
8.2. Expiration Action
Xóa hoặc hết hạn đối tượng sau một khoảng thời gian.
Ví dụ:
- Xóa log file sau 365 ngày.
- Xóa các phiên bản cũ nếu versioning được kích hoạt.
- Xóa các phần tải lên không hoàn chỉnh sau 2 tuần.
Áp dụng quy tắc theo tiêu chí
- Prefix: Áp dụng cho một phần cụ thể của bucket.
- Tags: Áp dụng cho các đối tượng có tag cụ thể, ví dụ: chỉ thực hiện với dữ liệu của phòng tài chính.
9. Amazon S3 Replication
Amazon S3 Replication là một tính cho phép bạn tự động sao chép đối tượng từ một S3 bucket này sang bucket khác, giúp tăng cường khả năng bảo vệ dữ liệu, phân tán dữ liệu địa lý và tuân thủ chính sách doanh nghiệp.
9.1. Các dạng replication chính
| Loại Replication | Tên gọi | Mục đích chính |
|---|---|---|
| Cross-Region Replication | CRR | Sao chép dữ liệu giữa các vùng (regions) khác nhau |
| Same-Region Replication | SRR | Sao chép dữ liệu trong cùng một vùng |
9.2. Điều kiện cấu hình Replication
- Cả bucket nguồn và bucket đích phải bật Versioning. Nếu chưa bật, replication sẽ không hoạt động.
- Bucket đích có thể thuộc cùng tài khoản AWS hoặc tài khoản khác, phù hợp cho các tình huống như chia sẻ dữ liệu giữa bộ phận hoặc giữa các khách hàng.
- Replication là bất đồng bộ (asynchronous) — việc sao chép không diễn ra theo thời gian thực mà thực hiện trong nền.
- Cần tạo IAM Role dành riêng cho replication, với quyền:
- Đọc từ bucket nguồn
- Ghi vào bucket đích
- (Tùy chọn) Quản lý thẻ (tagging), ACL nếu cần
9.3. Các Trường Hợp Sử Dụng Thực Tế
Cross-Region Replication (CRR)
- Tuân thủ dữ liệu theo khu vực (data sovereignty)
- Khả năng phục hồi khu vực (Disaster Recovery): chuyển sang vùng khác khi vùng chính gặp sự cố
- Phân phối nội dung toàn cầu: lưu trữ dữ liệu gần người dùng để giảm độ trễ
- Sao chép sang tài khoản khác để tách biệt môi trường sản xuất và sao lưu
Same-Region Replication (SRR)
- Tổng hợp log từ nhiều bucket vào một bucket duy nhất để phục vụ phân tích
- Giữ cho môi trường kiểm thử luôn đồng bộ với môi trường sản xuất
- Tạo bản sao để giám sát hoặc kiểm tra dữ liệu nhạy cảm
10. S3 Event Notifications
Event Notifications trong Amazon S3 được kích hoạt khi các sự kiện cụ thể xảy ra trong bucket của bạn. Một số ví dụ về sự kiện bao gồm:
- Tạo đối tượng: Khi một đối tượng mới được tải lên S3.
- Xóa đối tượng: Khi một đối tượng bị xóa khỏi S3.
- Khôi phục đối tượng: Khi một đối tượng được khôi phục từ Glacier.
- Replication: Khi dữ liệu được sao chép từ bucket này sang bucket khác.
11. S3 Access Logs
Amazon S3 Access Logs là một tính năng quan trọng hỗ trợ ghi lại mọi truy cập đến một S3 bucket, bao gồm cả truy cập thành công và truy cập bị từ chối. Đây là một công cụ không thể thiếu trong các hệ thống yêu cầu tuân thủ nghiêm ngặt về bảo mật, giám sát hoặc điều tra sự cố truy cập.
Cách hoạt động:
- Khi bạn bật Access Logging cho một bucket:
- Mỗi request đến bucket đó (PUT, GET, DELETE, HEAD, v.v.) sẽ được ghi lại dưới dạng một dòng log.
- Các dòng log này sẽ được lưu vào một bucket đích khác (target bucket), cũng nằm trong cùng một region.
- Dữ liệu log sẽ có định dạng chuẩn, bao gồm thông tin như:
- IP của client
- Time request
- Request URI
- Response status
- Error code (nếu có)
- User Agent
- Requester (IAM role hoặc anonymous user)…
12. S3 Performance
12.1. Thời gian phản hồi và số lượng yêu cầu
- Thời gian phản hồi: S3 có thời gian phản hồi rất thấp, chỉ từ 100-200ms để gửi byte đầu tiên.
- Số lượng yêu cầu mỗi giây:
- 3,500 PUT/COPY/POST/DELETE mỗi giây trên mỗi prefix.
- 5,500 GET/HEAD mỗi giây trên mỗi prefix.
12.2. Hiểu về prefix trong S3
Prefix là phần nằm giữa tên bucket và tên file.
Ví dụ: Đối với một file nằm tại bucket/folder1/sub1/file, prefix sẽ là /folder1/sub1/.
- Mỗi prefix có thể xử lý độc lập số lượng yêu cầu nêu trên.
- Bằng cách sử dụng nhiều prefix khác nhau, bạn có thể tăng số lượng yêu cầu xử lý đồng thời trong bucket.
- Ví dụ: Nếu bạn phân bổ đều tải trên 4 prefix, bạn có thể đạt tới 22,000 yêu cầu GET/HEAD mỗi giây.
13. Cách Tối Ưu Hóa Hiệu Suất S3
13.1. Multi-Part Upload
Multi-Part Upload giúp tăng tốc tải lên các file lớn bằng cách chia file thành các phần nhỏ và tải lên song song.
- Khuyến nghị:
- Dùng Multi-Part Upload cho file lớn hơn 100 MB.
- Bắt buộc dùng Multi-Part Upload cho file lớn hơn 5 GB.
- Cách hoạt động:
- File được chia thành các phần nhỏ.
- Các phần này được tải lên đồng thời.
- S3 sẽ tự động ghép các phần lại thành một file hoàn chỉnh.
13.2. S3 Transfer Acceleration
Tăng tốc tải lên và tải xuống bằng cách sử dụng AWS Edge Locations.
- Dữ liệu được tải qua edge location gần nhất, sau đó truyền qua mạng nội bộ nhanh của AWS thay vì internet công cộng.
- Lợi ích:
- Tối ưu hóa tốc độ truyền dữ liệu trên khoảng cách xa.
- Tương thích với Multi-Part Upload.
- Ví dụ: Tải file từ Mỹ lên bucket ở Úc:
- Dữ liệu được truyền tới edge location tại Mỹ.
- Sau đó, edge location chuyển dữ liệu tới bucket ở Úc qua mạng nội bộ AWS.
13.3. Byte-Range Fetches
Cách tiếp cận này tối ưu hóa tải xuống bằng cách chỉ lấy các phần cần thiết của file hoặc tải xuống song song.
- Ứng dụng:
- Tải các phần nhỏ của file để xử lý riêng biệt.
- Tăng tốc tải xuống file lớn bằng cách chia thành các byte range và tải song song.
- Ví dụ:
- Nếu file có phần header chứa thông tin quan trọng, bạn chỉ cần tải xuống phần đầu tiên (ví dụ: 50 bytes) thay vì toàn bộ file.
14. Kết luận
Amazon S3 là giải pháp lưu trữ mạnh mẽ, linh hoạt và phù hợp cho mọi nhu cầu từ lưu trữ cơ bản đến các trường hợp sử dụng phức tạp. Với khả năng mở rộng vô hạn, S3 giúp doanh nghiệp tối ưu hóa chi phí và đảm bảo dữ liệu luôn an toàn.
Hãy bắt đầu khám phá Amazon S3 ngay trên giao diện console của AWS để hiểu rõ hơn cách dịch vụ này hoạt động!