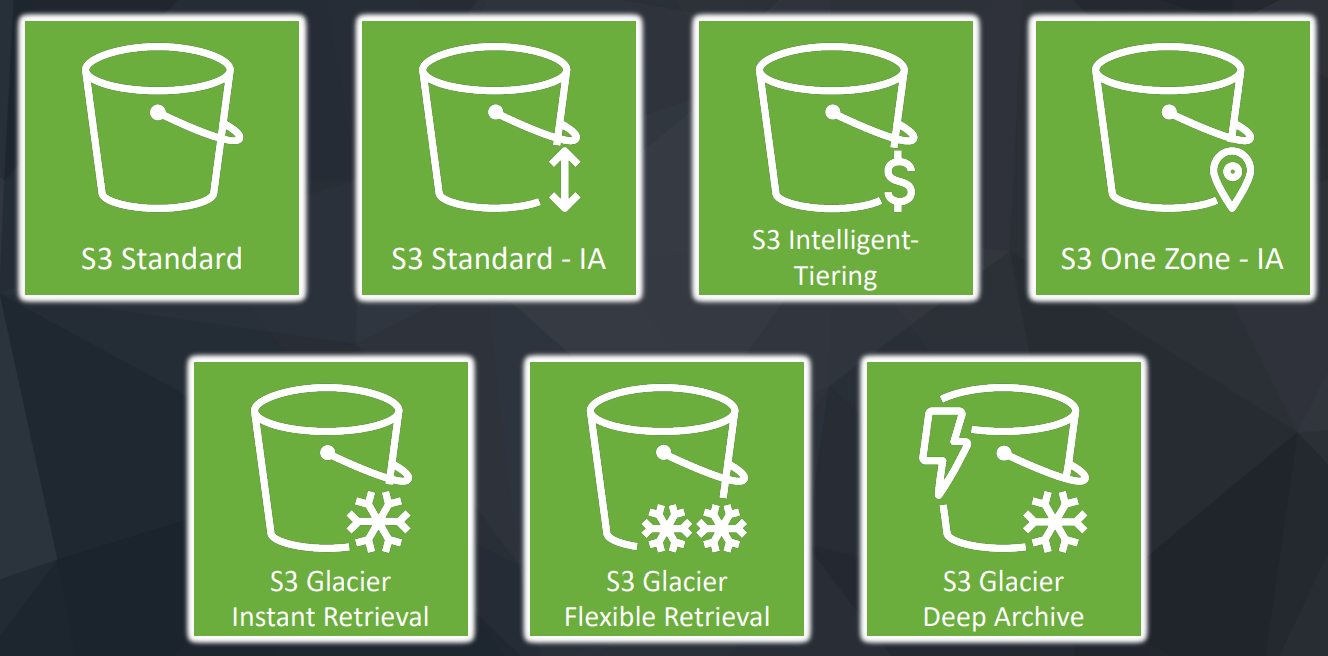
Amazon S3 storage classes là các lớp lưu trữ của amazon simple storage service amazon s3, mỗi lớp cân bằng khác nhau giữa chi phí, tốc độ truy xuất và độ sẵn sàng. AWS có 7 lớp chính: S3 Standard, Standard-IA, One Zone-IA, Intelligent-Tiering, Glacier Instant Retrieval, Glacier Flexible Retrieval và Glacier Deep Archive, và bạn chọn lớp theo từng object, không theo bucket.
Amazon S3 storage classes là gì?
Amazon S3 storage classes là các nhóm lưu trữ trong S3, mỗi nhóm được thiết kế cho một kiểu truy cập dữ liệu khác nhau. Điểm khác biệt nằm ở ba thứ: hiệu năng, độ sẵn sàng/độ bền, và chi phí (gồm cả phí truy xuất).
Hãy hình dung tủ quần áo: đồ mùa đông, đồ mùa hè, đồ lễ phục mỗi loại một ngăn, bạn lấy theo thời tiết. Dữ liệu cũng vậy. Nếu coi mọi dữ liệu như nhau thì bạn sẽ phí tài nguyên.
Ba use case điển hình khiến AWS phải chia nhiều lớp:
- Lưu trữ dài hạn cho compliance: log, hợp đồng, tài liệu pháp lý, gần như không bao giờ đọc lại.
- Truy cập tức thì: dữ liệu cho database, ứng dụng, phân tích thời gian thực.
- File lớn phân phối toàn cầu: video, phim, dùng cho streaming.
Storage class được gán theo bucket hay theo object?
Storage class được gán theo từng object, không phải theo cả bucket. Đây là điều nghe thì nhỏ nhưng rất quan trọng khi thiết kế lưu trữ.
Một bucket có thể chứa hàng triệu object, mỗi object nằm ở một class khác nhau. Cùng một bucket my-app-data, bạn có thể để ảnh đang dùng ở S3 Standard, backup tháng trước ở Standard-IA, và log năm ngoái ở Glacier.
Điều này mang lại:
- Tối ưu chi phí theo đúng mẫu truy cập của từng object.
- Không cần tách nhiều bucket chỉ để đổi giá lưu trữ.
- Có thể tự động chuyển class bằng lifecycle rule (phần dưới).
Nếu upload mà không chỉ định gì, object mặc định vào S3 Standard.
Có những storage class nào trong Amazon S3?
Có 7 storage class chính:
| Storage class | Giá trị trong CLI | Dùng cho |
|---|---|---|
| S3 Standard | STANDARD |
Dữ liệu truy cập thường xuyên, hiệu năng cao |
| S3 Standard-IA | STANDARD_IA |
Dữ liệu ít truy cập nhưng cần lấy nhanh |
| S3 One Zone-IA | ONEZONE_IA |
Ít truy cập, tái tạo được, chỉ cần 1 AZ |
| S3 Intelligent-Tiering | INTELLIGENT_TIERING |
Mẫu truy cập không rõ hoặc thay đổi |
| S3 Glacier Instant Retrieval | GLACIER_IR |
Lưu trữ lâu, thỉnh thoảng cần lấy ngay |
| S3 Glacier Flexible Retrieval | GLACIER |
Lưu trữ lâu, chấp nhận chờ phút đến giờ |
| S3 Glacier Deep Archive | DEEP_ARCHIVE |
Lưu trữ rất lâu, rẻ nhất, chờ lâu |
S3 Standard dùng khi nào?
S3 Standard là lớp mặc định, hiệu năng cao nhất, dùng cho dữ liệu bạn truy cập thường xuyên. Dữ liệu được nhân bản tối thiểu qua 3 Availability Zone.
Mình dùng Standard khi:
- Dữ liệu ứng dụng, ảnh, file tĩnh của website đang chạy.
- Dữ liệu tạm thời, không tồn tại lâu nên không đáng tối ưu.
- Chưa biết mẫu truy cập và muốn đơn giản.
Nhược điểm duy nhất: giá lưu trữ trên mỗi GB cao hơn các lớp phía dưới.
S3 Standard-IA khác gì S3 Standard?
S3 Standard-IA (Infrequent Access) rẻ hơn Standard ở phần lưu trữ, nhưng bạn trả thêm phí mỗi lần truy xuất. Dữ liệu vẫn được lấy tức thì, vẫn nhân bản qua nhiều AZ.
Nên dùng cho backup, dữ liệu disaster recovery, hoặc file cũ ít đọc nhưng khi cần phải có ngay.
Hai điều cần nhớ:
- Có thời gian lưu tối thiểu 30 ngày và kích thước tính phí tối thiểu 128 KB mỗi object.
- Nếu object bị đọc liên tục, phí truy xuất có thể làm tổng chi phí cao hơn Standard.
S3 One Zone-IA phù hợp với trường hợp nào?
S3 One Zone-IA lưu dữ liệu ít truy cập trong một Availability Zone duy nhất thay vì ba. Vì ít bản sao hơn nên giá rẻ hơn Standard-IA.
Đổi lại, nếu AZ đó gặp sự cố nghiêm trọng thì dữ liệu có thể mất. Vì vậy chỉ dùng cho dữ liệu tái tạo được hoặc đã có bản sao ở nơi khác.
Ví dụ hợp lý:
- Bản sao thứ hai của dữ liệu đã backup ở region khác.
- Thumbnail, file trung gian có thể sinh lại từ bản gốc.
Không dùng cho dữ liệu duy nhất, quan trọng.
S3 Intelligent-Tiering là gì và khi nào nên dùng?
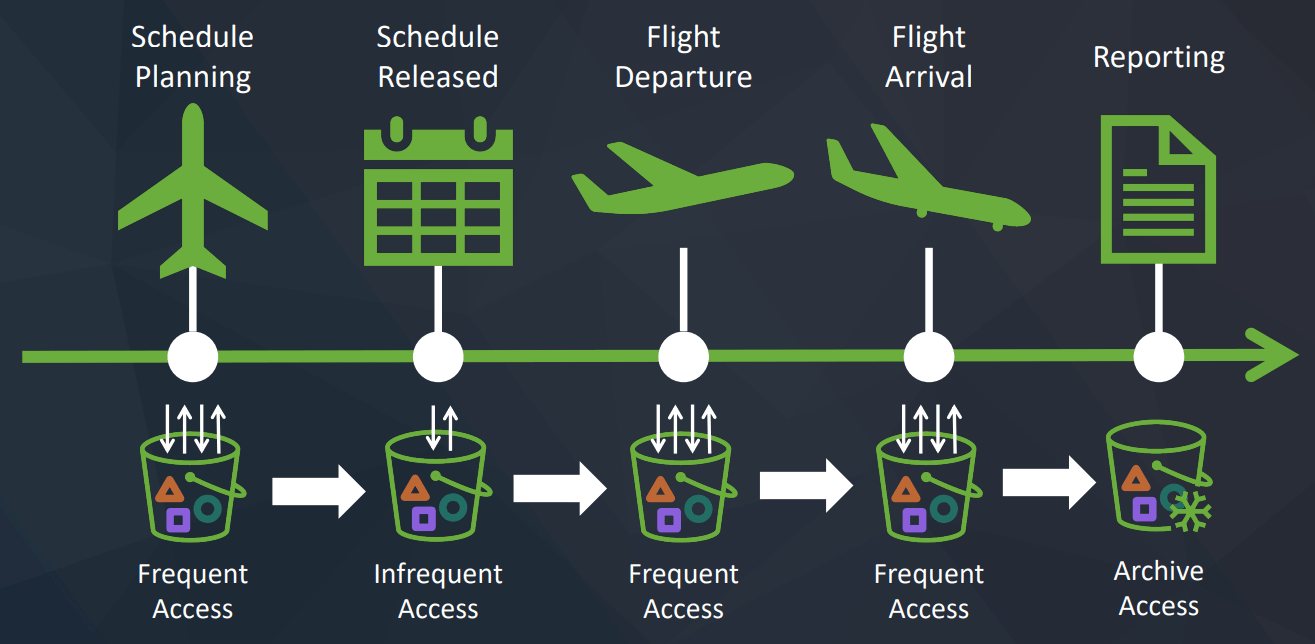
S3 Intelligent-Tiering tự động chuyển object giữa các tầng truy cập dựa trên hành vi sử dụng thực tế, phù hợp khi bạn không biết hoặc mẫu truy cập hay thay đổi. Bạn không phải tự viết rule.
Điểm đáng lưu ý là có một khoản phí giám sát/tự động hóa nhỏ theo số object. Với object rất nhỏ thì không hiệu quả.
Mình hay chọn lớp này cho:
- Data lake, dữ liệu phân tích mà team khác dùng, mình không kiểm soát được tần suất đọc.
- Dữ liệu mới, chưa có đủ số liệu để quyết định Standard hay IA.
S3 Glacier có những lớp nào?
S3 Glacier là nhóm 3 lớp dành cho lưu trữ dài hạn, giá rất rẻ. Khác nhau chủ yếu ở tốc độ lấy lại dữ liệu.
- Glacier Instant Retrieval: lấy lại tức thì, dành cho dữ liệu lưu lâu nhưng thỉnh thoảng cần ngay (ví dụ tài liệu pháp lý có thể bị yêu cầu đột xuất). Thời gian lưu tối thiểu 90 ngày.
- Glacier Flexible Retrieval: phải khôi phục trước khi đọc. Theo tài liệu AWS, Expedited mất khoảng 1–5 phút, Standard 3–5 giờ, Bulk 5–12 giờ. Thời gian lưu tối thiểu 90 ngày.
- Glacier Deep Archive: rẻ nhất trong tất cả, cho dữ liệu gần như không bao giờ đọc. Thời gian lấy lại tính bằng giờ (thường trong 12 giờ với Standard, 48 giờ với Bulk). Thời gian lưu tối thiểu 180 ngày.
So sánh nhanh các S3 storage class như thế nào?
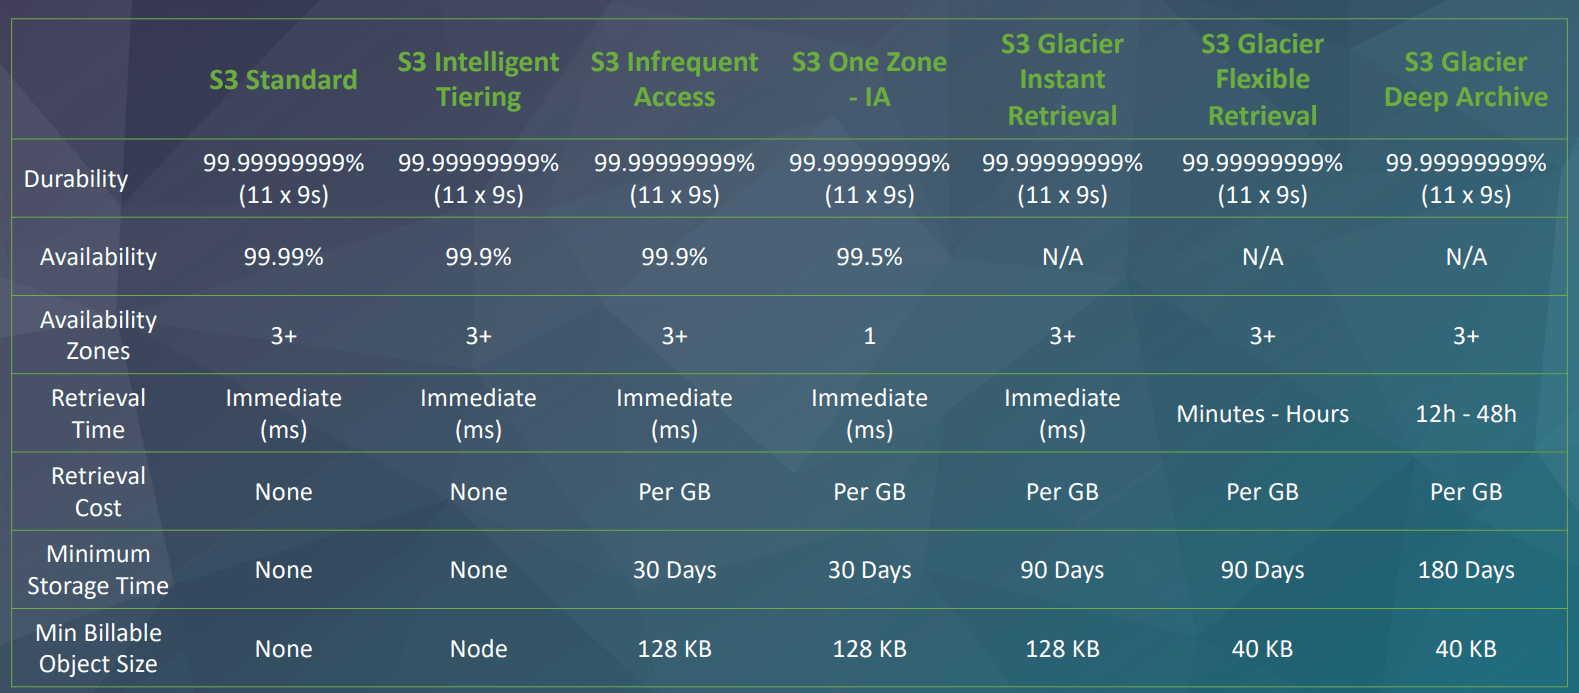
Bảng dưới đây là phần mình hay mở lại khi cần chọn nhanh. Số liệu độ sẵn sàng và thời gian lưu tối thiểu lấy theo tài liệu AWS tại thời điểm viết; bạn nên kiểm tra lại trang chính thức vì AWS có thể cập nhật.
Làm sao để chọn đúng S3 storage class?
Cách chọn thực tế là tự hỏi 3 câu: bao lâu đọc một lần, cần lấy nhanh đến mức nào, và mất dữ liệu thì hậu quả ra sao. Từ đó chọn lớp tương ứng.
Bảng quyết định mình dùng:
| Tình huống | Gợi ý |
|---|---|
| Đọc hằng ngày, cần hiệu năng | S3 Standard |
| Backup ít đọc, cần lấy ngay | S3 Standard-IA |
| Dữ liệu tái tạo được, muốn rẻ hơn | S3 One Zone-IA |
| Không biết tần suất truy cập | S3 Intelligent-Tiering |
| Lưu lâu, thỉnh thoảng cần ngay | Glacier Instant Retrieval |
| Lưu lâu, chờ vài giờ được | Glacier Flexible Retrieval |
| Compliance nhiều năm, gần như không đọc | Glacier Deep Archive |